Un plantage serveur peut interrompre brutalement l’accès aux applications, aux fichiers, aux bases de données ou à certains services essentiels d’une entreprise. Mais un serveur indisponible n’est pas forcément victime d’une cyberattaque : une saturation des ressources, une panne matérielle, un problème logiciel, une erreur de configuration ou encore un incident électrique peuvent produire des symptômes similaires.
La priorité consiste donc à identifier la cause avant d’engager des opérations de restauration ou des modifications importantes. Une fois l’incident maîtrisé, l’objectif est de comprendre pourquoi il s’est produit et de mettre en place les mesures nécessaires pour réduire le risque de récidive.
Qu’est-ce qu’un plantage serveur ?
Un serveur est considéré comme en panne lorsqu’il ne fournit plus correctement les services attendus : il peut être complètement inaccessible, redémarrer de manière répétée, devenir extrêmement lent ou perdre l’accès à certaines ressources.
Le problème peut concerner l'ensemble du serveur ou seulement un composant. Un serveur peut par exemple continuer à fonctionner alors qu’un volume de stockage est devenu inaccessible ou qu’un service applicatif ne répond plus.
Cette distinction est importante pour le diagnostic. Avant de conclure à une panne complète, il faut déterminer :
- si le serveur est réellement inaccessible ;
- si tous les utilisateurs sont concernés ;
- si un seul service ou une seule application est en panne ;
- si le problème concerne le réseau, le stockage, le système ou une application ;
- si l’incident est apparu après une modification récente ;
- si des erreurs sont visibles dans les journaux système ou applicatifs.
Quelles sont les principales causes d’un plantage serveur ?
Les causes d’une panne serveur sont nombreuses. Une approche efficace consiste à les regrouper par grandes catégories afin de ne pas partir immédiatement sur une hypothèse unique.
Surcharge CPU, mémoire ou stockage
Un serveur peut devenir instable lorsque ses ressources sont durablement sollicitées au-delà de ce que son environnement peut supporter.
Une consommation excessive du processeur, de la mémoire ou du stockage peut notamment entraîner des ralentissements importants, des erreurs applicatives ou une indisponibilité du service.
Le stockage mérite également une attention particulière. Un volume saturé ou présentant des erreurs peut provoquer des problèmes d’accès aux fichiers et aux applications.
Mesure préventive : mettre en place une surveillance des ressources et des alertes adaptées afin d’identifier une dérive avant qu’elle ne provoque une indisponibilité.
Défaillance matérielle
Un serveur peut également tomber en panne à la suite de la défaillance d'un composant :
- disque ou système de stockage ;
- mémoire vive ;
- alimentation ;
- contrôleur de stockage ;
- ventilateur ou système de refroidissement ;
- carte réseau ;
- autre composant matériel.
Les problèmes de stockage sont particulièrement sensibles lorsqu'ils affectent les données ou les volumes utilisés par les applications.
Mesure préventive : surveiller l'état du matériel, maintenir les firmwares et pilotes à jour lorsque cela est nécessaire et prévoir une stratégie adaptée de redondance ou de remplacement des composants critiques.
Problème logiciel ou mise à jour
Une panne peut apparaître après :
- une mise à jour du système ;
- l'installation d'un logiciel ;
- une modification de pilote ;
- une incompatibilité entre composants ;
- un dysfonctionnement d'une application ;
- une corruption de fichiers système.
Le moment où l'incident apparaît constitue alors une information importante. Une panne survenue immédiatement après une modification ne prouve pas nécessairement que celle-ci est responsable, mais elle doit faire partie des éléments examinés.
Mesure préventive : documenter les changements réalisés sur les serveurs et éviter les modifications non maîtrisées sur les environnements de production.
Erreur de configuration ou intervention humaine
Une mauvaise configuration peut également rendre un serveur ou un service indisponible.
Cela peut concerner :
- une modification de droits ;
- une règle réseau ;
- une configuration DNS ;
- un paramètre système ;
- un service arrêté ;
- une modification de stockage ;
- une suppression accidentelle ;
- une intervention réalisée sans procédure de retour arrière.
Dans ce type de situation, le serveur n'est pas nécessairement « cassé » au sens matériel du terme. Il peut simplement ne plus être capable de fournir correctement le service attendu.
Mesure préventive : formaliser les changements importants, documenter la configuration et limiter les droits d'administration aux personnes qui en ont réellement besoin.
Incident électrique ou environnemental
Une coupure électrique, une surtension, une température excessive ou un problème de refroidissement peuvent également provoquer une panne.
Le risque dépend notamment de l'environnement physique du serveur et de son niveau de protection.
Mesure préventive : protéger l'infrastructure contre les incidents électriques et surveiller les conditions environnementales lorsque cela est pertinent.
Cyberincident
Un serveur peut enfin devenir indisponible à la suite d'un incident de sécurité : rançongiciel, compromission, attaque ciblant une application ou autre activité malveillante.
Mais un serveur qui plante n'est pas automatiquement victime d'une cyberattaque.
Les symptômes doivent être analysés avec les autres indices disponibles : événements inhabituels, comptes compromis, fichiers chiffrés ou modifiés, processus inconnus, connexions suspectes ou apparition simultanée de problèmes sur plusieurs systèmes.
Mesure préventive : associer maintenance, contrôle des accès, mises à jour, sauvegardes protégées et mesures de cybersécurité.
Quelles conséquences pour une entreprise ?
Les conséquences d'une panne serveur dépendent du rôle du serveur et de la durée de l'indisponibilité.
Un serveur peut par exemple héberger des fichiers, une application métier, une base de données, des services d'authentification ou d'autres ressources nécessaires au fonctionnement quotidien.
Une panne peut alors entraîner :
- une interruption d'accès aux applications ;
- une impossibilité d'accéder à certains fichiers ;
- un ralentissement ou un arrêt de la production ;
- une interruption de certains échanges avec les clients ;
- une perte ou une corruption de données ;
- du temps consacré au diagnostic et au rétablissement ;
- des conséquences financières liées à l'indisponibilité.
La situation est particulièrement délicate lorsque l'entreprise ne sait pas précisément quelles données sont sauvegardées, où elles sont stockées et si elles peuvent réellement être restaurées.
C'est pourquoi la sauvegarde ne doit pas être considérée comme une simple copie automatique. La vérification régulière de l'intégrité des sauvegardes et de la capacité à les restaurer est essentielle.
Que faire lorsqu’un serveur plante ?
Lorsqu'un serveur devient indisponible, la première erreur serait de multiplier immédiatement les manipulations sans avoir conservé les informations permettant de comprendre l'incident.
La démarche doit être progressive.
Sécuriser et qualifier l’incident
Avant toute action importante, il faut déterminer ce qui est réellement indisponible.
Quelques questions permettent de cadrer rapidement la situation :
- Le serveur répond-il encore au réseau ?
- Tous les utilisateurs sont-ils concernés ?
- Une seule application est-elle touchée ?
- Le serveur a-t-il redémarré ?
- Une modification récente a-t-elle été réalisée ?
- D'autres équipements présentent-ils le même problème ?
- Existe-t-il des signes pouvant indiquer un incident de sécurité ?
Si une compromission est suspectée, il faut éviter les manipulations susceptibles de détruire des éléments utiles au diagnostic et appliquer la procédure de gestion d'incident prévue par l'entreprise.
Vérifier journaux, ressources et matériel
Le diagnostic doit ensuite rechercher des éléments objectifs.
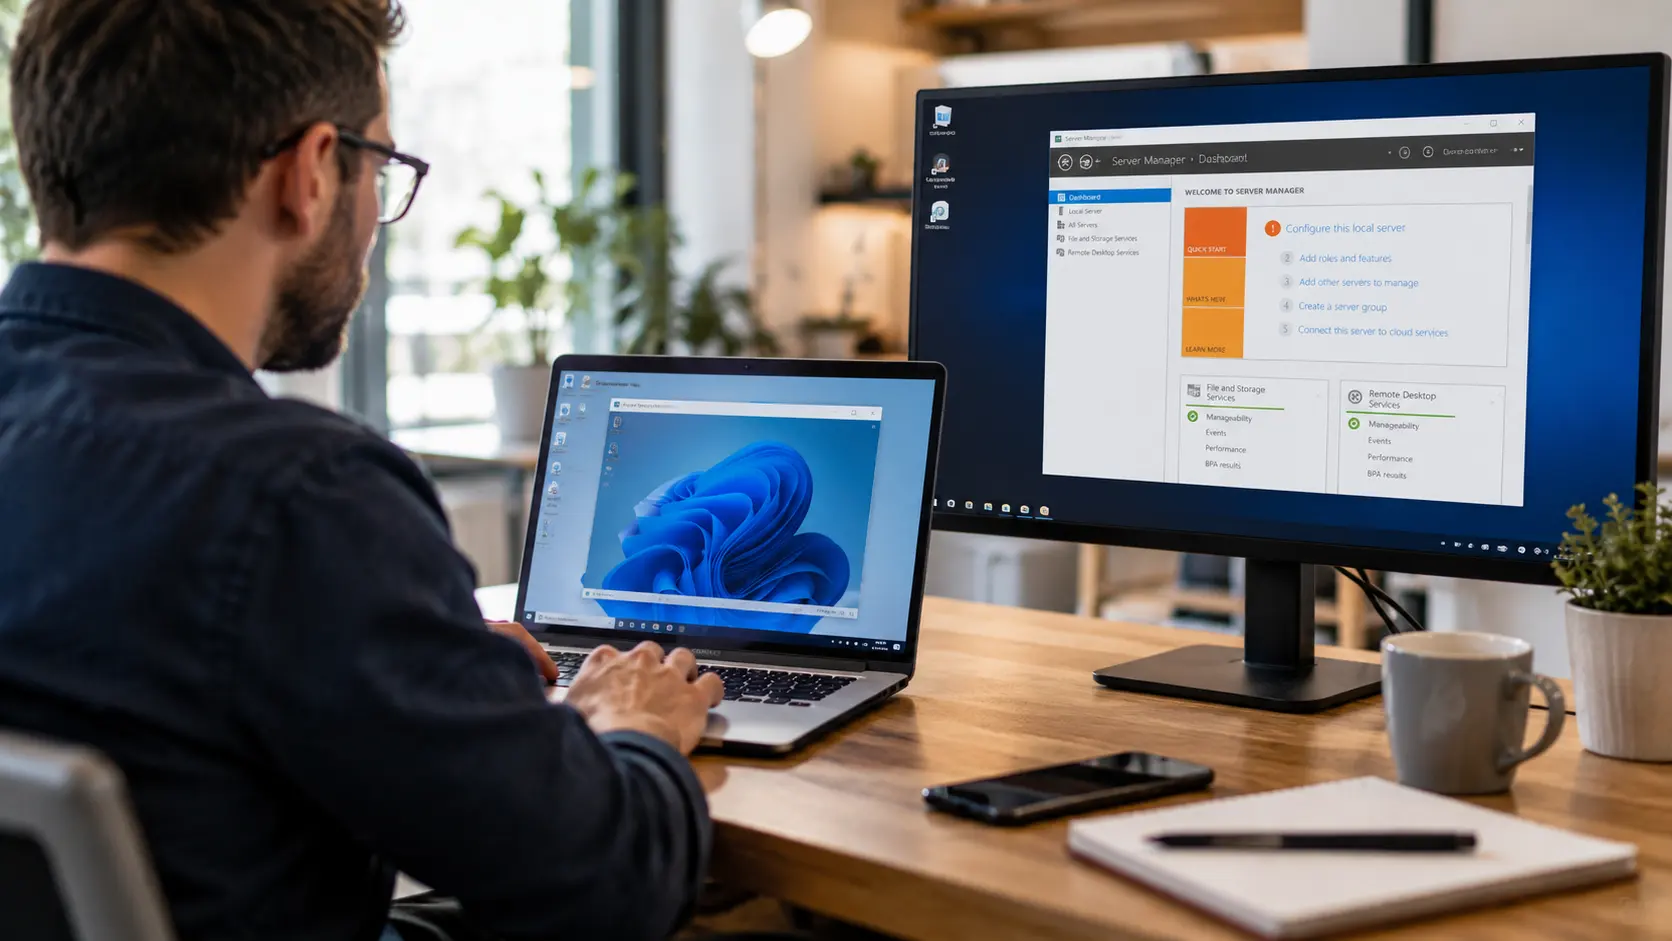
Sur un environnement Windows Server, les journaux d'événements peuvent fournir des informations sur les erreurs système, les services et le stockage. Les outils de performance peuvent également aider à identifier une saturation du processeur ou de la mémoire.
Il est également pertinent de vérifier :
- l'espace disponible sur les volumes ;
- l'état des disques ;
- les erreurs matérielles ;
- les services arrêtés ;
- les changements récents ;
- les pilotes et firmwares concernés ;
- les erreurs applicatives ;
- les connexions réseau ;
- les éventuels symptômes de compromission.
Restaurer le service sans aggraver l’incident
La restauration doit intervenir une fois que le scénario est suffisamment compris et que la méthode de rétablissement a été choisie.
Selon la situation, il peut être préférable de :
- corriger une configuration ;
- redémarrer un service ;
- remplacer un composant défaillant ;
- restaurer un fichier ou une base ;
- restaurer un système complet ;
- basculer vers une infrastructure de secours.
Le choix dépend du type de panne et de la criticité du service.
En cas d'incident de sécurité, une restauration doit être réalisée avec une vigilance supplémentaire. Il faut notamment utiliser une source de confiance et contrôler les éléments restaurés lorsqu'une compromission est suspectée.
Comment prévenir un nouveau plantage ?
Résoudre une panne ne suffit pas toujours. Si la cause n'est pas identifiée, le même problème peut se reproduire.
La prévention repose donc sur plusieurs niveaux complémentaires.
Supervision et maintenance
La surveillance permet de détecter des signes précurseurs : augmentation inhabituelle de la consommation mémoire, saturation du stockage, erreurs matérielles répétées ou dégradation des performances.
Les outils de supervision doivent cependant être associés à des procédures : une alerte sans personne chargée de l'analyser et d'intervenir apporte peu de valeur.
La maintenance consiste également à suivre les mises à jour, l'état matériel, les capacités de stockage et les changements réalisés sur l'infrastructure.
Maintenance informatique OM Conseil
Sauvegardes et tests de restauration
Une sauvegarde serveur doit permettre de récupérer les données ou systèmes nécessaires lorsque l'original n'est plus disponible.
Mais la présence d'une sauvegarde ne garantit pas automatiquement sa restauration.
Une stratégie sérieuse doit prévoir des copies suffisamment protégées et séparées de la production, ainsi que des tests réguliers de restauration.
Elle doit également préciser :
- quelles données sont critiques ;
- quelles données doivent être sauvegardées ;
- où les copies sont conservées ;
- qui peut y accéder ;
- comment une restauration est déclenchée ;
- comment la restauration est testée ;
- comment les sauvegardes sont protégées contre une compromission.
PRA/PCA et procédures d’escalade
Le PRA (plan de reprise d'activité) et le PCA (plan de continuité d'activité) répondent à une question plus large : comment maintenir ou rétablir les activités essentielles lorsqu'un incident important affecte le système d'information ?
Il n'existe pas de RTO ou de RPO universel applicable à toutes les entreprises. Ces objectifs doivent être définis en fonction des activités, des dépendances et du niveau d'interruption acceptable.
Un dispositif de continuité ou de reprise doit également préciser les rôles de chacun : qui détecte l'incident, qui décide de basculer vers un environnement de secours, qui contacte les prestataires et qui valide le retour à la normale ?
FAQ
Pourquoi un serveur plante-t-il ?
Un plantage serveur peut avoir différentes causes : surcharge des ressources, défaillance matérielle, problème logiciel, erreur de configuration, incident électrique ou cyberincident. Le diagnostic doit permettre d'identifier la cause avant de choisir la méthode de rétablissement.
Comment savoir si un plantage serveur vient d'une surcharge ?
Il faut notamment examiner l'utilisation du processeur, de la mémoire et du stockage, ainsi que les journaux et les données de performance. Une utilisation élevée constitue un indice, mais elle ne suffit pas nécessairement à expliquer à elle seule la panne.
Un plantage serveur signifie-t-il qu'il y a eu une cyberattaque ?
Non. Une panne serveur peut avoir une origine matérielle, logicielle, électrique ou humaine. Un cyberincident fait partie des hypothèses possibles, mais il doit être confirmé ou étayé par des éléments techniques.
Que faire si un serveur ne redémarre plus ?
Il faut d'abord qualifier la panne et rechercher les éléments disponibles dans les journaux, l'environnement matériel et le stockage. Si des données critiques sont concernées, il est préférable d'éviter les opérations susceptibles de les dégrader avant d'avoir déterminé la procédure adaptée.
Une sauvegarde suffit-elle pour protéger une entreprise contre une panne serveur ?
Non. Il faut également vérifier que les sauvegardes sont accessibles, protégées et réellement restaurables. Une copie qui n'a jamais été testée ne permet pas de garantir que la restauration fonctionnera au moment nécessaire.
Pourquoi tester la restauration des sauvegardes ?
Parce qu'une sauvegarde peut exister sans être exploitable au moment où l'entreprise en a besoin. Les tests permettent de vérifier que les données peuvent effectivement être récupérées et que la procédure de restauration fonctionne.
Quelle différence entre sauvegarde, PRA et PCA ?
La sauvegarde concerne la conservation de copies permettant notamment de récupérer des données ou des systèmes. Le PRA organise la reprise après une interruption importante. Le PCA vise plus largement à maintenir les activités essentielles pendant une situation perturbée. Ces dispositifs sont complémentaires et doivent être adaptés aux besoins réels de l'entreprise.
Conclusion
Un plantage serveur n'a pas une cause unique. Saturation, panne matérielle, problème logiciel, erreur de configuration, incident électrique et cyberincident peuvent tous conduire à une indisponibilité, mais ils ne se traitent pas de la même manière.
La priorité est donc de qualifier l'incident avant d'intervenir, puis de rechercher sa cause à partir des journaux, des ressources disponibles, de l'état matériel et du contexte récent.
À plus long terme, la prévention repose sur une combinaison de supervision, maintenance, sauvegardes testées, protection des accès et procédures de continuité ou de reprise. Cette approche permet de transformer une panne ponctuelle en retour d'expérience exploitable, plutôt que de simplement remettre le serveur en fonctionnement sans traiter la cause du problème.
Pour les entreprises qui souhaitent structurer la surveillance, la maintenance et le support de leur infrastructure, l'infogérance informatique OM Conseil peut également constituer un prolongement naturel de cette démarche.